Les concepts de base de la Web Audio API
Cet article explique une partie de la thorie sur laquelle s'appuient les fonctionnalits de la Web Audio API. Il ne fera pas de vous un ingnieur du son, mais vous donnera les bases ncessaires pour comprendre pourquoi la Web Audio API fonctionne de cette manire, et vous permettre de mieux l'utiliser.
Dans cet article
- Graphes audio
- Donnes audio: ce qu'on trouve dans un chantillon
- Mmoire tampon : trames, chantillons et canaux
- Canaux audio
- Visualisations
- Spatialisations
- Fan-in et Fan-out
Graphes audio
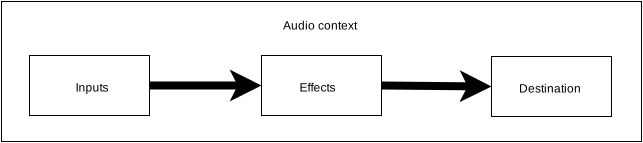
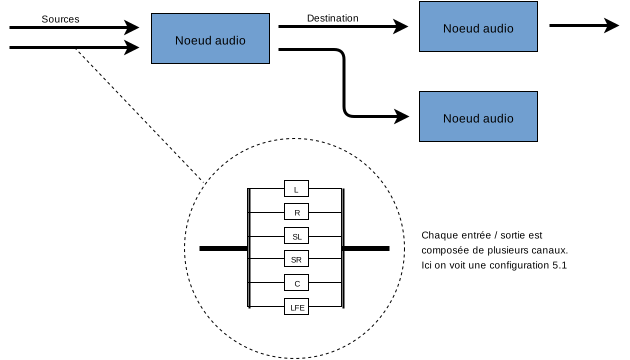
La Web Audio API implique d'effectuer le traitement du son dans un contexte audio; elle a t conue sur le principe de routage modulaire. Les oprations basiques sont effectues dans noeuds audio, qui sont lis entre eux pour former un graphe de routage audio. Un seul contexte peut supporter plusieurs sources avec diffrentes configurations de canaux. Cette architecture modulaire assure la flexibilit ncessaire pour crer des fonctions audio complexes avec des effets dynamiques.
Les noeuds audio sont lis au niveau de leur entre et leur sortie, formant une chane qui commence avec une ou plusieurs sources, traverse un ou plusieurs noeuds, et se termine avec une sortie spcifique (bien qu'il ne soit pas ncessaire de spcifier une sortie si, par exemple, vous souhaitez seulement visualiser des donnes audio). Un scnario simple, reprsentatif de la Web Audio API, pourrait ressembler ceci :
- Cration d'un contexte audio
- Dans ce contexte, cration des sources telles que
<audio>, oscillateur, flux - Cration des noeuds d'effets, tels que rverb, filtres biquad, balance, compresseur
- Choix final de la sortie audio, par exemple les enceintes du systme
- Connection des sources aux effets, et des effets la sortie.

Chaque entre ou sortie est compose de plusieurs canaux, chacun correspondant une configuration audio spcifique. Tout type de canal discret est support, y compris mono, stereo, quad, 5.1, etc.

Les sources audio peuvent tre de provenance varie :
- gnres directement en JavaScript avec un noeud audio (tel qu'un oscillateur)
- cres partir de donnes PCM brutes (le contexte audio a des mthodes pour dcoder les formats audio supports)
- fournies par une balise HTML media (telle que
<video>ou<audio>) - rcupres directement avec WebRTC
MediaStream(une webcam ou un microphone)
Donnes audio: ce qu'on trouve dans un chantillon
Lors du traitement d'un signal audio, l'chantillonage dsigne la conversion d'un signal continu en signal discret; formul autrement, une onde de son continue, comme un groupe qui joue en live, est convertie en une squence d'chantillons (un signal temporel discret) qui permet l'ordinateur de traiter le son en blocs distincts.
On peut trouver davantage de dtails sur la page Wikipdia Echantillonage (signal).
Mmoire tampon : trames, chantillons et canaux
Un AudioBuffer prend comme paramtres un nombre de canaux (1 pour mono, 2 pour stro, etc), une longueur, qui correspond au nombre de trames d'chantillon dans la mmoire tampon, et un taux d'chantillonage, qui indique le nombre de trames d'chantillons lues par seconde.
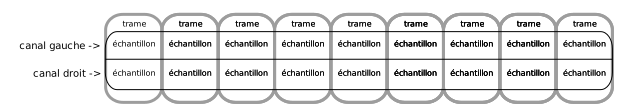
Un chantillon est une valeur float32 unique, qui correspond la valeur du flux audio un point prcis dans le temps, sur un canal spcifique (gauche ou droit dans le cas de la stro). Une trame, ou trame d'chantillon est l'ensemble de toutes les valeurs pour tous les canaux (deux pour la stro, six pour le 5.1, etc.) un point prcis dans le temps.
Le taux d'chantillonage est le nombre d'chantillons (ou de trames, puisque tous les chantillons d'une trame jouent en mme temps) qui sont jous en une seconde, exprims en Hz. Plus le taux d'chantillonage est lev, meilleure est la qualit du son.
Prenons deux AudioBuffer, l'un en mono et l'autre en stro, chacun d'une dure de 1 seconde et d'une frquence de 44100Hz:
- le mono aura 44100 chantillons, et 44100 trames. Sa proprit
lengthvaudra 44100. - le stro aura 88200 chantillons, et 44100 trames. Sa proprit
lengthvaudra aussi 44100, puisqu'elle correspond au nombre de trames.

Lorsqu'un noeud de mmoire tampon est lu, on entend d'abord la trame la trame la plus gauche, puis celle qui la suit droite, etc. Dans le cas de la stro, on entend les deux canaux en mme temps. Les trames d'chantillon sont trs utiles, car elles reprsentent le temps indpendamment du nombre de canaux.
Note : Pour obtenir le temps en secondes partir du nombre de trames, diviser le nombre de trames par le taux d'chantillonage. Pour obtenir le nombre de trames partir du nombre d'chantillons, diviser le nombre d'chantillons par le nombre de canaux.
Voici quelques exemples simples:
var contexte = new AudioContext();
var memoireTampon = contexte.createBuffer(2, 22050, 44100);
Note : 44,100 Hz (que l'on peut aussi crire 44.1 kHz) est un taux d'chantillonage couramment utilis. Pourquoi 44.1kHz ?
D'abord, parce ce que le champ auditif qui peut tre peru par des oreilles humaines se situe peu prs entre 20 Hz et 20,000 Hz, et que selon le thorme d'chantillonage de NyquistShannon la frquence d'chantillonage doit tre suprieure deux fois la frquence maximum que l'on souhaite reproduire; le taux d'chantillonage doit donc tre suprieur 40 kHz.
De plus, le signal doit tre trait par un filtre passe-bas avant d'tre chantillon, afin d'viter le phnomne d'aliasing, et, si en thorie un filtre passe-bas idal devrait tre capable de laisser passer les frquences infrieures 20 kHz (sans les attnuer) et de couper parfaitement les frquences suprieures 20 kHz, en pratique une bande de transition dans laquelle les frquences sont partiellement attnues est ncessaire. Plus la bande de transition est large, plus il est facile et conomique de faire un filtre anti-aliasing. Le taux d'chantillonage 44.1 kHz laisse une bande de transition de 2.05 kHz.
Ce code gnre une mmoire tampon stro (deux canaux) qui, lorsqu'elle est lue dans un AudioContext 44100Hz (configuration rpandue, la plupart des cartes sons tournant cette frquence), dure 0.5 secondes: 22050 trames / 44100Hz = 0.5 secondes.
var contexte = new AudioContext();
var memoireTampon = context.createBuffer(1, 22050, 22050);
Ce code gnre une mmoire tampon mono (un seul canal) qui, lorsqu'elle est lue dans un AudioContext 44100Hzz, est automatiquement *rchantillonne* 44100Hz (et par consquent produit 44100 trames), et dure 1.0 seconde: 44100 frames / 44100Hz = 1 seconde.
Note : Le rchantillonnage audio est trs similaire la redimension d'une image : imaginons que vous ayiez une image de 16 x 16, mais que vous vouliez remplir une surface de 32x32: vous la redimensionnez (rchantillonnez). Le rsultat est de qualit infrieure (il peut tre flou ou crnel, en fonction de l'algorithme de redimensionnement), mais cela fonctionne, et l'image redimensionne prend moins de place que l'originale. C'est la mme chose pour le rchantillonnage audio vous gagnez de la place, mais en pratique il sera difficle de reproduire correctement des contenus de haute frquence (c'est--dire des sons aigus).
Mmoire tampon linaire ou entrelace
La Web Audio API utilise un format de mmoire tampon linaire : les canaux gauche et droite sont stocks de la faon suivante :
LLLLLLLLLLLLLLLLRRRRRRRRRRRRRRRR (pour un buffer de 16 trames)
C'est assez courant dans le traitement audio, car cela permet de traiter facilement chaque canal de faon indpendante.
L'alternative est d'utiliser un format entrelac:
LRLRLRLRLRLRLRLRLRLRLRLRLRLRLRLR (pour un buffer de 16 trames)
Ce format est communment utilis pour stocker et lire du son avec trs peu de traitement, comme par exemple pour un flux de MP3 dcod.
La Web Audio API expose *uniquement* des buffer linaires, car elle est faite pour le traitement du son. Elle fonctionne en linaire, mais convertit les donnes au format entrelac au moment de les envoyer la carte son pour qu'elles soient joues. A l'inverse, lorsqu'un MP3 est dcod, le format d'origine entrelac est converti en linaire pour le traitement.
Canaux audio
Une mmoire tampon audio peut contenir diffrents nombres de canaux, depuis les configurations simple mono (un seul canal) ou stro (canal gauche et canal droit) en allant jusqu des configurations plus complexe comme le quad ou le 5.1, pour lesquels chaque canal contient plusieurs chantillons de sons, ce qui permet une exprience sonore plus riche. Les canaux sont gnralement reprsents par les abbrviations standard dtailles dans le tableau ci-aprs :
| Mono | 0: M: mono |
| Stereo |
0: L: gauche
|
| Quad |
0: L: gauche
|
| 5.1 |
0: L: gauche
|
Conversion ascendante et descendante
Lorsque le nombre de canaux n'est pas le mme en entre et en sortie, on effectue une conversion ascendante ou descendante selon les rgles suivantes. Cela peut tre plus ou moins controll en assignant la valeur speakers ou discrete la proprit AudioNode.channelInterpretation .
| Interprtation | Canaux d'entre | Canaux de sortie | Rgles de conversion |
|---|---|---|---|
speakers |
1 (Mono) |
2 (Stro) |
Conversion ascendante de mono vers stro. Le canal d'entre M est utilis pour les deux canaux de sortie
(L et R).output.L = input.M
|
1 (Mono) |
4 (Quad) |
Conversion ascendante de mono vers quad. Le canal d'entre M est utilis pour les canaux de sortie autres que surround
(L et R). Les canaux de sortie surround (SL
et SR) sont silencieux.output.L = input.M
|
|
1 (Mono) |
6 (5.1) |
Conversion ascendante de mono vers 5.1. Le canal d'entre M est utilis pour le canal de sortie central
(C). Tous les autres canaux (L,
R, LFE, SL, et SR)
sont silencieux.output.L = 0output.C = input.M
|
|
2 (Stro) |
1 (Mono) |
Conversion descendante de stro vers mono. Les deux canaux d'entre ( L et R) sont combines pour
produire l'unique canal de sortie (M).output.M = 0.5 * (input.L + input.R)
|
|
2 (Stro) |
4 (Quad) |
Conversion ascendante de stro vers quad. Les canaux d'entre L et R input sont utiliss pour leurs
quivalents respectifs non-surround en sortie (L et
R). Les canaux de sortie surround (SL et
SR) sont silencieux.output.L = input.L
|
|
2 (Stro) |
6 (5.1) |
Conversion ascendante de stro vers 5.1. Les canaux d'entre L et R sont utiliss pour leurs
quivalents respectifs non-surround en sortie (L et
R). Les canaux de sortie surround (SL et
SR), ainsi que le canal central (C) et le
canal subwoofer (LFE) restent silencieux.output.L = input.L
|
|
4 (Quad) |
1 (Mono) |
Conversion descendante de quad vers mono. Les quatre canaux de sortie ( L, R, SL, et
SR) sont combins pour produire l'unique canal de sortie
(M).output.M = 0.25 * (input.L + input.R + input.SL + input.SR)
|
|
4 (Quad) |
2 (Stro) |
Conversion descendante de quad vers stro. Les deux canaux d'entre gauche ( L and SL) sont
combins pour produire l'unique canal de sortie gauche
(L). De la mme faon, les deux canaux d'entre droite
(R et SR) sont combins pour produire l'unique
canal de sortie droite (R).output.L = 0.5 * (input.L + input.SL)output.R = 0.5 * (input.R + input.SR)
|
|
4 (Quad) |
6 (5.1) |
Conversion ascendante de quad vers 5.1. Les canaux d'entre L, R, SL, et
SR sont utiliss pour leur canaux de sortie quivalents
respectifs (L and R). Le canal central
(C) et le canal subwoofer (LFE) restent
silencieux.output.L = input.L
|
|
6 (5.1) |
1 (Mono) |
Conversion descendante de 5.1 vers mono. Les canaux de gauche ( L et SL), de droite (R et
SR) et central sont tous mixs ensemble. Les canaux
surround sont lgrement attnus et la puissance des canaux latraux
est compense pour la faire compter comme un seul canal en la
multipliant par 2/2. Le canal subwoofer (LFE)
est perdu.output.M = 0.7071 * (input.L + input.R) + input.C + 0.5 * (input.SL +
input.SR)
|
|
6 (5.1) |
2 (Stro) |
Conversion descendante de 5.1 vers stro. Le canal central ( C) est additionn avec chacun des canaux latraux
(SL et SR) puis combin avec chacun des canaux
latraux (L et R). Comme il est converti en deux canaux, il est mix
une puissance infrieure : multipli par 2/2. Le canal
subwoofer (LFE) est perdu.output.L = input.L + 0.7071 * (input.C + input.SL)+ 0.7071 * (input.C + input.SR)
|
|
6 (5.1) |
4 (Quad) |
Conversion descendante de 5.1 vers quad. Le canal central ( C) est combin avec les canaux latraux non-surround
(L et R). Comme il est converti en deux
canaux, il est mix une puissance infrieure : multipli par
2/2. Les canaux surround restent inchangs. Le canal
subwoofer (LFE) est perdu.output.L = input.L + 0.7071 * input.C
|
|
| Autres configurations non-standard |
Les configurations non-standard sont traites comme si la proprit
channelInterpretation avait la valeur
discrete.La spcification autorise explicitement la dfinition venir de nouvelles configurations de sortie pour les enceintes. Ce cas de figure n'est par consquent pas garanti dans le futur, car le comportement des navigateurs pour un nombre spcifique de canaux pourrait tre amen changer. |
||
discrete |
tout (x) |
tout (y) pour lequel x<y
|
Conversion ascendante de canaux discrets. Remplit chaque canal de sortie avec son quivalent en entre, c'est--dire le canal qui a le mme index. Les canaux de sortie qui n'ont pas d'quivalent en entre restent silencieux. |
tout (x) |
tout (y) pour lequel x>y |
Conversion descendante de canaux discrets. Remplit chaque canal de sortie avec son quivalent en entre, c'est--dire le canal qui a le mme index. Les canaux d'entre qui n'ont pas d'quivalent en sortie sont perdus. |
|
Visualisations
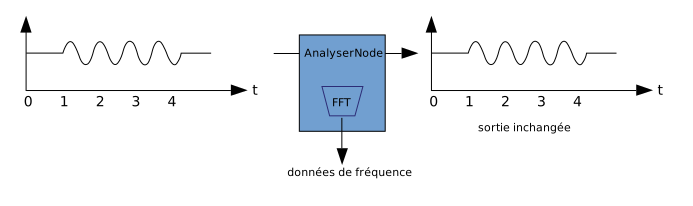
Une visualisation audio consiste en gnral utiliser un flux de donnes audio dans le temps (souvent des informations de gain ou de frquence) pour gnrer un affichage graphique (comme un graphe). La Web Audio API possde un AnalyserNode qui n'altre pas le signal audio qui le traverse, permettant de gnrer des donnes qui peuvent tre utilises par une technologie de visualisation telle que <canvas>.

On peut accder aux donnes en utilisant les mthodes suivantes:
AnalyserNode.getFloatFrequencyData()-
Copie les donnes de frquence dans le tableau
Float32Arraypass en argument.
AnalyserNode.getByteFrequencyData()-
Copies les donnes de frquence dans le tableau d'octets non signs
Uint8Arraypass en argument.
AnalyserNode.getFloatTimeDomainData()-
Copie les donnes de l'onde de forme, ou domaine temporel, dans le
Float32Arraypass en argument. AnalyserNode.getByteTimeDomainData()-
Copie les donnes de l'onde de forme, ou domaine temporel, dans le tableau d'octets non signs
Uint8Arraypass en argument.
Note : Pour plus d'informations, voir notre article Visualizations with Web Audio API.
Spatialisations
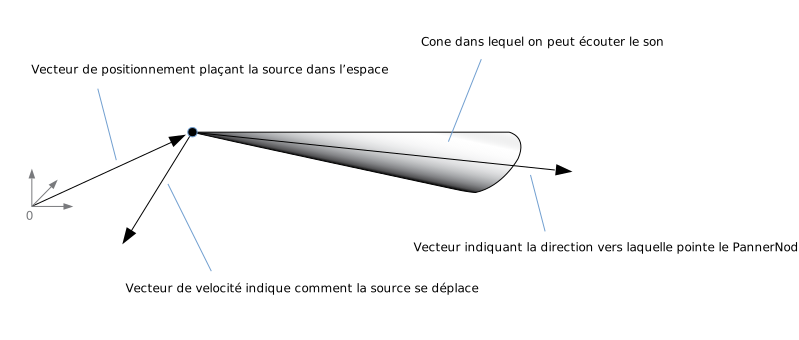
Une spatialisation audio (gre par les noeuds PannerNode et AudioListener dans la Web Audio API) permet de modliser la position et le comportement d'un signal audio situ dans l'espace, ainsi que l'auditeur qui peroit ce signal.
La position du panoramique est dcrite avec des coodonnes cartsiennes selon la rgle de la main droite, son mouvement l'aide d'un vecteur de vlocit (ncessaire pour la cration d'effets Doppler) et sa direction avec un cone de direction. Le cone peut tre trs large, par exemple dans le cas de sources omnidirectionnelles.
 [Le PannerNode donne la position dans l'espace, la vlocit et la direction d'un signal donn]
La position de l'auditeur est dcrite avec des coodonnes cartsiennes selon la rgle de la main droite, son mouvement l'aide d'un vecteur de vlocit et la direction vers laquelle elle pointe en utilisant deux vecteurs de direction : haut et face. Ceux-ci dfinissent respectivement la direction vers laquelle pointent le haut de la tte et le bout du nez de l'auditeur, et forment un angle droit entre eux.

Note : For more information, see our Web audio spatialization basics article.
Fan-in et Fan-out
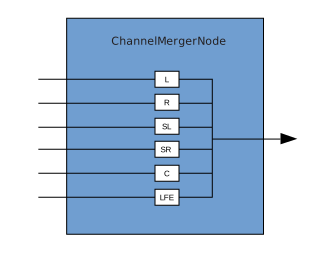
En audio, fan-in dsigne le processus par lequel un ChannelMergerNode prend une srie d'entres mono entre et restitue un seul signal multi-canaux :

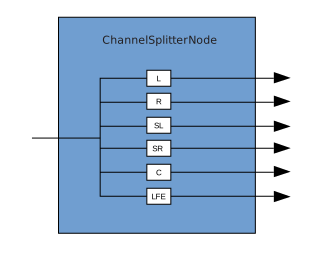
Fan-out dsigne le processus oppos, par lequel un ChannelSplitterNode prend une source multi-canaux en entre et restitue plusieurs signaux mono en sortie: